بسیاری از سازمانهای بزرگ که از سیستمهای برنامهریزی منابع سازمانی (ERP) استفاده میکنند، در دو سال اول فعالیت خود با یک چالش غافلگیرکننده مواجه میشوند: «کند شدن تدریجی سیستم». این پدیده که در نگاه اول ممکن است به ضعف سختافزار یا خطای برنامهنویسی نسبت داده شود، در واقع ریشه در مدیریت ناکارآمد دادهها و عدم معماری صحیح پایگاهداده دارد. شرکتهایی که در حوزه پخش مویرگی، هایپرمارکتهای زنجیرهای یا تولید با تیراژ بالا فعالیت میکنند، روزانه با هزاران تراکنش، صدها ثبت سند انبار و کوئریهای پیچیده روی فاکتورها دستوپنجه نرم میکنند. وقتی تعداد ردیفهای جداول کلیدی مانند account_move_line یا stock_move از مرز میلیونها میگذرد، دیتابیس دیگر مانند روزهای اول پرشتاب عمل نمیکند.
در این مقاله، قصد داریم بدون ورود به حواشی تئوریک، به سراغ تکنیکهای مهندسیمحور برای بهینهسازی پایگاهداده PostgreSQL در بستر Odoo برویم و بررسی کنیم چگونه میتوان با تیونینگ هوشمند، پیادهسازی ایندکسهای استراتژیک و مدیریت چرخه حیات داده، سرعت سیستم را حتی در مقیاسهای عظیم بازیابی کرد.
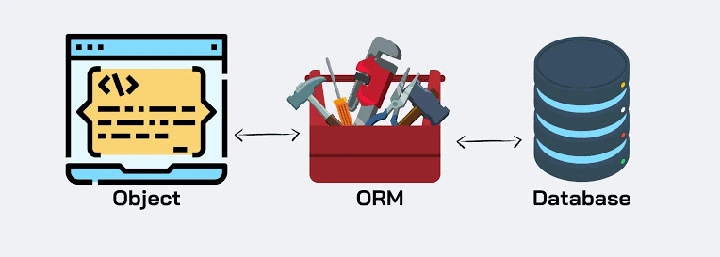
تحلیل کالبدشکافی مشکل؛ چرا اودوو در مقیاس بالا کند میشود؟
اودوو از یک لایه انتزاعی به نام ORM (Object-Relational Mapping) استفاده میکند. این لایه، برنامهنویسی را برای توسعهدهندگان بسیار ساده میکند، اما یک واقعیت ناخوشایند دارد: گاهی اوقات کوئریهای تولید شده توسط ORM بهینه نیستند یا منجر به اجرای Sequential Scan در PostgreSQL میشوند.
وقتی شما یک فرم سفارش فروش (Sale Order) را باز میکنید، اودوو چندین کوئری برای بارگذاری خطوط سفارش، وضعیت موجودی و موجودی حساب مشتری اجرا میکند. در دیتابیسهای کوچک، این عملیات در کسری از ثانیه انجام میشود. اما وقتی جدول stock_move ده میلیون رکورد دارد و شما ایندکسگذاری مناسبی روی فیلدهای پرکاربرد ندارید، دیتابیس مجبور است برای پیدا کردن هر رکورد، کل جدول را اسکن کند. نتیجه؟ سیستم برای باز کردن یک فرم ساده، ثانیهها معطل میشود و کاربران با تجربه کاربری ناامیدکنندهای روبرو میشوند.
علاوه بر این، رشد بیرویه دادههای لاگ (Log) و جداول موقت (Temp tables) در اودوو، فضای دیسک و حافظه کش (RAM) را اشغال میکند و باعث میشود Buffer Cache دیتابیس کارایی خود را از دست بدهد.
مقاله پیشنهادی: Docker برای چه پروژههایی واقعاً ارزش دارد؟
تیونینگ PostgreSQL؛ فراتر از تنظیمات پیشفرض
اولین قدم برای مقابله با کندی، بهینهسازی تنظیمات هسته PostgreSQL است. بسیاری از نصبهای اودوو از تنظیمات پیشفرض استفاده میکنند که برای یک دیتابیس کوچک مناسب است، اما برای یک ERP سازمانی که ده گیگابایت داده دارد، فاجعهبار است.
تنظیمات حافظه و کش
پارامتر shared_buffers قلب تپنده دیتابیس شماست. این مقدار تعیین میکند که چه میزان از دادههای دیتابیس در رم ذخیره شوند تا دسترسی سریعتر انجام شود. برای سرورهای اختصاصی، تخصیص ۲۵ درصد از کل رم سرور به این پارامتر معمولاً نقطه شروع خوبی است. همچنین پارامتر work_mem باید به دقت تنظیم شود؛ اگر این مقدار خیلی کم باشد، عملیات مرتبسازی و جوینهای پیچیده به دیسک منتقل میشود (که بسیار کند است) و اگر خیلی زیاد باشد، با تعدد کاربران، سرور با کمبود رم مواجه میشود.
بهینهسازی فرآیند I/O
دیسکهای HDD قدیمی دشمن شماره یک سیستمهای ERP هستند. اگر هنوز روی HDDهای معمولی هستید، اولین گام تیونینگ شما باید انتقال به SSDهای NVMe باشد. اما در لایه نرمافزاری، پارامترهای effective_io_concurrency و random_page_cost نقش حیاتی دارند. با تنظیم صحیح random_page_cost (که معمولاً برای SSDها باید به ۱.۱ کاهش یابد)، به کوئریپلنر (Query Planner) PostgreSQL میفهمانید که خواندن تصادفی دادهها از روی دیسک ارزان است و او را تشویق میکنید که به جای اسکن کامل، از ایندکسها استفاده کند.
استراتژیهای ایندکسگذاری پیشرفته (Indexing Strategy)
ایندکسها شمشیر دو لبه هستند. ایندکسگذاری روی همه فیلدها باعث میشود عملیات نوشتن (Insert/Update) به شدت کند شود. هنر DBA در این است که بداند کجا ایندکس بگذارد و کجا خیر.
استفاده از Partial Indexing
بسیاری از جداول اودوو شامل دادههایی هستند که ندرتاً فیلتر میشوند. برای مثال، وضعیت سفارشها. اگر شما اغلب فقط سفارشهای «در انتظار تأیید» را جستجو میکنید، نیازی نیست کل جدول را ایندکس کنید. شما میتوانید از Partial Index استفاده کنید:
CREATE INDEX idx_sale_order_waiting ON sale_order (id) WHERE state = 'draft';
این کار باعث میشود ایندکس بسیار کوچک و سریع باقی بماند و فقط رکوردهای مورد نیاز شما را در بر بگیرد.
ایندکسهای ترکیبی (Composite Indexes)
اگر کوئریهای شما همیشه بر اساس چند ستون همزمان انجام میشود (مثلاً جستجوی کالا بر اساس product_id و warehouse_id)، یک ایندکس ترکیبی بسازید. ترتیب ستونها در ایندکس ترکیبی بسیار مهم است؛ ستونی که بیشترین کاردینالیته (تنوع مقادیر) را دارد باید در ابتدای لیست قرار گیرد.
مدیریت دادههای حجیم: پارتیشنبندی و آرشیو هوشمند
وقتی جدول stock_move یا account_move_line به حجمهای چند ده میلیون رکورد میرسد، حتی بهترین ایندکسها هم محدودیتهای فیزیکی پیدا میکنند. در این مرحله، پارتیشنبندی (Table Partitioning) وارد میدان میشود.
مقاله پیشنهادی: PaaS چیست؟ راهنمای کامل Platform as a Service برای توسعهدهندگان
پارتیشنبندی بر اساس زمان
بهترین استراتژی برای سیستمهای ERP، پارتیشنبندی جداول تراکنشی بر اساس زمان (ماهانه یا فصلی) است. برای مثال، جداول حرکت کالا را بر اساس تاریخ پارتیشنبندی میکنیم. دیتابیس به جای جستجو در ده میلیون رکورد، فقط در پارتیشن مربوط به ماه جاری جستجو میکند. این کار عملکرد SELECT را به شکل چشمگیری افزایش میدهد.
در اودوو، این فرآیند چالشبرانگیز است زیرا ORM اودوو به طور پیشفرض از پارتیشنبندی پشتیبانی نمیکند. بنابراین تیم فنی باید از Inheritance در دیتابیس استفاده کند یا پیادهسازیهای خاصی (مانند pg_partman) را مدیریت کند تا کوئریها به صورت خودکار به پارتیشنهای صحیح هدایت شوند.
استراتژی آرشیو دادهها (Data Archiving)
آیا واقعاً نیاز دارید دادههای تراکنشهای سال ۱۳۹۹ را در دیتابیس آنلاین داشته باشید؟ پاسخ در ۹۰ درصد مواقع خیر است. پیادهسازی یک استراتژی آرشیو، یعنی انتقال دادههای قدیمی به یک دیتابیس جداگانه (Cold Storage) و نگه داشتن سوابق در دیتابیس اصلی فقط برای گزارشگیریهای ضروری. این کار نه تنها دیتابیس اصلی را سبک میکند، بلکه باعث میشود بکاپگیریهای شبانه سریعتر انجام شود و در صورت بروز فاجعه، بازیابی سیستم (Restore) به جای چند ساعت، در چند دقیقه انجام شود.
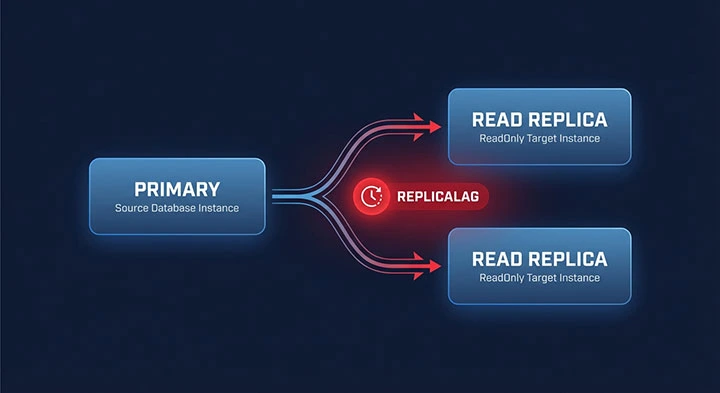
مقیاسپذیری با Read Replica
در محیطهای عملیاتی که تعداد کاربران بالاست، جدا کردن بار خواندن (Read) از بار نوشتن (Write) یک ضرورت است. شما میتوانید یک یا چند Read Replica از دیتابیس اصلی خود ایجاد کنید. با استفاده از این تکنیک، تمام عملیات گزارشگیریهای سنگین و کوئریهای تحلیلی را به سمت Replicaها هدایت میکنید.
بدین ترتیب، دیتابیس اصلی شما فقط مسئول مدیریت تراکنشها (ثبت فاکتور، تأیید انبار) خواهد بود و به دلیل اینکه درگیر پردازش گزارشهای سنگین نیست، سرعت ثبت تراکنشها کاهش نمییابد. در اودوو این کار نیازمند تنظیمات در database.conf یا استفاده از ابزارهای میانی برای مدیریت اتصال به دیتابیس است.
بهینهسازی کوئریهای ORM؛ پیشگیری بهتر از درمان است
گاهی اوقات مشکل از سختافزار نیست، بلکه از نحوه کدنویسی ماژولهاست. استفاده از ORM Methods به صورت غیربهینه یکی از شایعترین دلایل کندی است.
اجتناب از N+1 Query
بزرگترین قاتل عملکرد در اودوو، مشکل N+1 است. این مشکل زمانی رخ میدهد که شما یک لیست از رکوردها را میگیرید و برای هر رکورد، یک کوئری دیگر در حلقه (Loop) اجرا میکنید تا یک فیلد خاص را بخوانید.
راهکار ساده است: استفاده از متدهایی مثل prefetch و mapped یا بهینهسازی کوئریها با read_group و joins. همیشه به جای اجرای متد در حلقه، سعی کنید دادهها را به صورت دستهای (Batch) فراخوانی کنید.
محدود کردن فیلدها
در متدهای search یا read، همیشه فیلدهایی که واقعاً نیاز دارید را مشخص کنید. استفاده از * (انتخاب همه فیلدها) باعث انتقال حجم عظیمی از دادههای غیرضروری از دیتابیس به سرور اپلیکیشن میشود که علاوه بر کندی شبکه، مصرف رم سرور اودوو را نیز به شدت بالا میبرد.
مقاله پیشنهادی: Puppet چیست و چگونه زیرساختهای شما را مدیریت میکند؟
تحلیل لاگهای دیتابیس؛ چگونه بفهمیم کجا کند هستیم؟
بدون ابزار نظارت، کورکورانه تیراندازی میکنید. PostgreSQL ابزارهای فوقالعادهای برای شناسایی کندی دارد.
- pg_stat_statements: این اکستنشن ضروری است. بعد از فعالسازی، به شما لیستی از سنگینترین کوئریهای سیستم را میدهد. میتوانید ببینید کدام کوئری بیشترین زمان پردازش را داشته و چند بار اجرا شده است.
- EXPLAIN ANALYZE: وقتی کوئری مشکوکی پیدا کردید، آن را با دستور EXPLAIN ANALYZE اجرا کنید تا دقیقاً ببینید دیتابیس کجا وقت خود را تلف میکند؛ آیا Sequential Scan انجام میدهد؟ آیا جوینهای بسیار سنگین انجام میدهد؟
مقاله پیشنهادی: پایگاه داده PostgreSQL چیست؟ همه چیز درباره پایگاه داده پستگرس
جمعبندی: مدیریت زیرساخت، یعنی تداوم کسبوکار
مدیریت دیتابیس در اودوو صرفاً یک وظیفه فنی نیست؛ بلکه تضمینکننده تداوم زنجیره تأمین و فروش شماست. وقتی سیستم در لحظات حساس، مثل زمان ثبت فاکتورهای پایان ماه، کند عمل کند، هزینههای انسانی و عملیاتی سنگینی به سازمان تحمیل میشود.
تیونینگ دیتابیس، استفاده از پارتیشنبندی و بهینهسازی کوئریها، نه یک هزینه، بلکه یک سرمایهگذاری برای جلوگیری از توقفهای ناخواسته است. با این حال، اجرای این موارد نیازمند دانش عمیق از معماری اودوو و PostgreSQL است. یک اشتباه کوچک در پیکربندی دیتابیس میتواند منجر به ناپایداری سیستم شود.
تیم متخصص تسهیلگستر، با تکیه بر تجربه چندین ساله در پیادهسازی سامانه ERP بومیسازیشده سازمانیار (Sazmanyar) و آشنایی عمیق با چالشهای دیتابیس در کسبوکارهای ایرانی، آماده است تا به شما در عبور از این گلوگاههای فنی کمک کند. ما از تحلیل زیرساخت تا پیادهسازی استراتژیهای پیشرفته پارتیشنبندی و تیونینگ، در کنار شما هستیم تا سیستم شما حتی با میلیونها تراکنش، با همان سرعت روز اول در دسترس باقی بماند.
اگر احساس میکنید سیستم شما زیر بار دادهها خسته شده است، برای دریافت مشاوره تخصصی، بررسی سلامت دیتابیس و دموهای فنی، با کارشناسان ما در تسهیلگستر تماس بگیرید. بیایید زیرساخت شما را برای رشد مقیاسپذیر آماده کنیم.
سوالات متداول (FAQ)
۱. آیا پارتیشنبندی دیتابیس در اودوو باعث بروز خطا در ماژولهای استاندارد میشود؟
پارتیشنبندی سطح دیتابیس معمولاً توسط اپلیکیشن اودوو قابل رؤیت نیست و ماژولها همچنان بدون مشکل کار میکنند. با این حال، در زمان نوشتن (Insert/Update) باید دقت کرد که پارتیشنها به درستی مدیریت شوند. این کار معمولاً در سطح زیرساخت و با تنظیمات PostgreSQL انجام میشود.
۲. چه زمانی باید به فکر Read Replica باشیم؟
زمانی که CPU سرور اصلی دیتابیس به دلیل اجرای گزارشهای تحلیلی و کوئریهای پیچیده دائماً درگیر است و این درگیری باعث تأخیر در ثبت تراکنشهای کاربران (مانند صدور فاکتور) میشود.
۳. بهترین راه برای شناسایی کوئریهای کند در اودوو چیست؟
استفاده از اکستنشن pg_stat_statements در PostgreSQL بهترین روش است. این ابزار به شما خروجی دقیقی از پرمصرفترین کوئریهای دیتابیس و زمان اجرای آنها میدهد که بر اساس آن میتوانید بهینهسازی را اولویتبندی کنید.
۴. آیا آرشیو کردن دادهها، تاریخچه فروش را از بین میبرد؟
خیر. آرشیو کردن به معنای حذف نیست، بلکه انتقال به یک دیتابیس آفلاین یا فضای سرد است. دادههای آرشیو شده همچنان برای گزارشهای سالانه و حسابرسی در دسترس هستند، اما از دیتابیس اصلی که روزانه با آن کار میکنید خارج میشوند تا سرعت را افزایش دهند.
۵. آیا برای همه سازمانها تیونینگ دیتابیس توصیه میشود؟
برای سازمانهای کوچک با حجم تراکنش کم، این کار اولویت اصلی نیست. اما برای هایپرمارکتها، شرکتهای پخش و تولیدیهایی که روزانه با تعداد ردیفهای بالای داده سروکار دارند، این تیونینگ نه یک انتخاب، بلکه یک ضرورت برای زنده ماندن سیستم است.