رشد مدلهای زبانی بزرگ، سامانههای پیشنهاددهنده، موتورهای جستوجوی هوشمند و دستیارهای سازمانی، نوع تازهای از مسئله را در مدیریت داده ایجاد کرده است. در این کاربردها دیگر کافی نیست یک عبارت را دقیقاً در میان متنها پیدا کنیم. سیستم باید بتواند مفهوم جمله، شباهت میان اسناد و ارتباط معنایی میان پرسش کاربر و محتوای ذخیرهشده را تشخیص دهد.
برای مثال، ممکن است کاربر عبارت «چطور هزینه نگهداری تجهیزات کارخانه را کاهش دهیم؟» را جستوجو کند، اما سند مناسب با عنوان «راهکارهای بهینهسازی تعمیرات پیشگیرانه ماشینآلات» ذخیره شده باشد. یک جستوجوی متنی ساده ممکن است به دلیل تفاوت واژهها نتواند این ارتباط را بهخوبی تشخیص دهد. در مقابل، جستوجوی معنایی میتواند بفهمد که این دو عبارت از نظر مفهومی به یک موضوع نزدیک هستند.
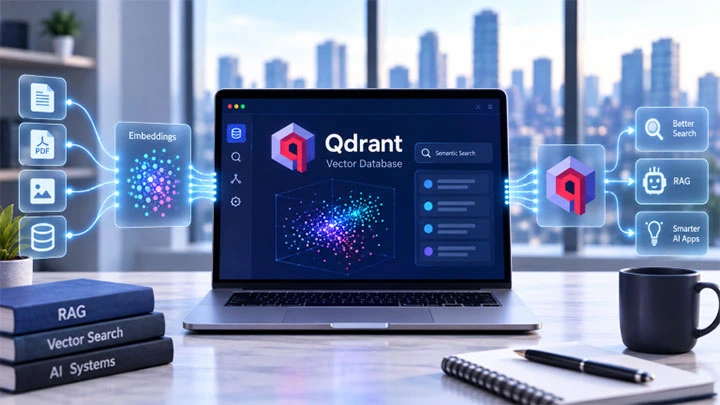
زیرساخت اصلی چنین قابلیتی، ترکیبی از مدلهای Embedding، بردارهای عددی، الگوریتمهای جستوجوی شباهت و دیتابیسهای برداری است. ابزارهایی مانند Qdrant نیز برای ذخیرهسازی، ایندکسگذاری، فیلترکردن و بازیابی سریع این بردارها طراحی شدهاند.
مقاله پیشنهادی: Redis چیست؟ کاربردها، ساختار دادهها و راهاندازی برای کش و صف
در این مقاله بررسی میکنیم دیتابیس برداری چیست، Embedding چگونه تولید میشود، جستوجوی شباهت چگونه کار میکند، Qdrant چه امکاناتی دارد و چرا پایگاههای داده برداری به یکی از اجزای اصلی معماری RAG تبدیل شدهاند.
دیتابیس برداری چیست؟
دیتابیس برداری یا Vector Database نوعی سامانه ذخیرهسازی و بازیابی داده است که برای نگهداری و جستوجوی بردارهای چندبعدی بهینه شده است.
در پایگاههای داده رابطهای معمولی، اطلاعات در قالب سطر، ستون، عدد، تاریخ و رشته متنی ذخیره میشوند. برای پیدا کردن دادهها نیز معمولاً از شروطی مانند برابری، بزرگتر یا کوچکتر بودن، تطبیق رشته و اتصال میان جداول استفاده میشود.
در دیتابیس برداری، هر شیء علاوه بر اطلاعات اصلی خود، یک نمایش عددی به نام بردار دارد. این بردار میتواند نماینده معنای یک متن، ویژگیهای یک تصویر، محتوای یک فایل صوتی، مشخصات یک محصول یا رفتار یک مشتری باشد.
مقاله پیشنهادی: مهاجرت داده و پاکسازی دیتای سمی پیش از استقرار ERP
برای مثال، یک رکورد در دیتابیس برداری ممکن است شامل این اجزا باشد:
- شناسه یکتای سند
- بردار Embedding سند
- متن اصلی یا بخشی از متن
- عنوان سند
- نوع محتوا
- واحد سازمانی مرتبط
- سطح دسترسی
- زبان محتوا
- زمان ایجاد یا بهروزرسانی
- سایر متادیتاهای موردنیاز
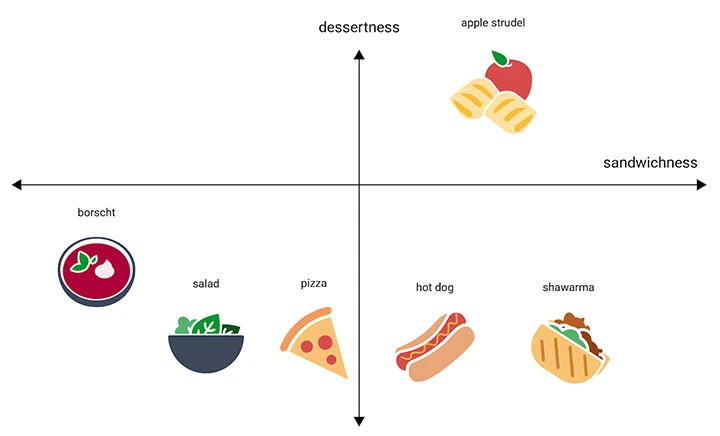
وظیفه اصلی دیتابیس برداری این است که پس از دریافت یک بردار ورودی، نزدیکترین بردارها را در فضای چندبعدی پیدا کند. نزدیکبودن بردارها معمولاً به معنای شباهت بیشتر محتوای آنهاست.
بنابراین، برخلاف دیتابیسهای سنتی که بیشتر به دنبال تطبیق دقیق مقادیر هستند، دیتابیس برداری برای پاسخدادن به پرسشی مانند «کدام دادهها از نظر معنایی به این ورودی نزدیکترند؟» طراحی شده است.
Embedding چیست و بردارها از کجا میآیند؟
Embedding نمایش عددی فشردهای از یک داده است. این داده میتواند متن، تصویر، صوت، ویدئو، کد برنامهنویسی، محصول یا حتی رفتار کاربر باشد.
یک مدل Embedding ورودی را دریافت میکند و آن را به مجموعهای از اعداد اعشاری تبدیل میکند. این مجموعه اعداد یک بردار چندبعدی را تشکیل میدهد. برای نمونه، یک جمله ممکن است به برداری با صدها یا هزاران مؤلفه تبدیل شود:
[0.021, -0.114, 0.387, 0.052, ...]
هر عدد بهتنهایی الزاماً مفهوم قابلتفسیر مشخصی ندارد. اهمیت اصلی در رابطه میان ابعاد و موقعیت کلی بردار در فضای برداری است. مدلهای Embedding طوری آموزش میبینند که دادههای مشابه را به نقاط نزدیک و دادههای نامرتبط را به نقاط دورتر نگاشت کنند.
برای مثال، بردار جمله «ثبت درخواست مرخصی کارکنان» احتمالاً به بردار جمله «فرایند تأیید مرخصی پرسنل» نزدیکتر از جمله «برنامهریزی تعمیرات دستگاه CNC» خواهد بود.
مقاله پیشنهادی: بهینهسازی دیتابیس اودوو؛ مدیریت دادههای حجیم در PostgreSQL
فرایند تولید Embedding برای اسناد
در یک سامانه جستوجوی سازمانی، تولید Embedding معمولاً شامل مراحل زیر است:
- اطلاعات از منابعی مانند فایلهای PDF، Word، صفحات وب، پایگاه دانش، سیستم ERP یا سامانه مدیریت اسناد استخراج میشود.
- متن پاکسازی و به قطعات کوچکتر یا Chunk تقسیم میشود.
- هر قطعه همراه با اطلاعات زمینهای مانند عنوان، بخش، شماره صفحه و سطح دسترسی آماده میشود.
- متن هر قطعه به مدل Embedding ارسال میشود.
- مدل، بردار متناظر با هر قطعه را تولید میکند.
- بردار، متن و متادیتای آن در دیتابیس برداری ذخیره میشوند.
هنگام جستوجو نیز پرسش کاربر با همان مدل Embedding به بردار تبدیل میشود. سپس دیتابیس نزدیکترین بردارهای اسناد را نسبت به بردار پرسش پیدا میکند.
چرا باید از یک مدل Embedding سازگار استفاده کرد؟
بردار پرسش و بردار اسناد باید در یک فضای برداری مشترک قرار داشته باشند. در بیشتر معماریها، این موضوع به معنای استفاده از یک مدل Embedding یکسان یا مدلهای کاملاً سازگار برای ایندکسکردن اسناد و پردازش پرسشهاست.
اگر اسناد با یک مدل و پرسشها با مدلی نامرتبط تبدیل شوند، ابعاد و معنای فضای برداری با یکدیگر سازگار نخواهد بود. در نتیجه، محاسبه شباهت خروجی قابلاعتمادی تولید نمیکند.
همچنین، تغییر مدل Embedding در یک سامانه عملیاتی معمولاً به بازتولید بردار اسناد یا Re-embedding نیاز دارد. به همین دلیل، نام مدل، نسخه مدل و ابعاد بردار باید بخشی از طراحی و حاکمیت داده باشند.
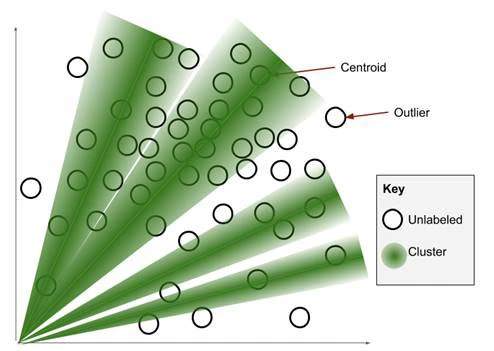
جستوجوی شباهت چگونه کار میکند؟
هدف جستوجوی شباهت این است که نزدیکترین بردارها به بردار پرسش را پیدا کند. برای اندازهگیری این نزدیکی میتوان از معیارهای مختلف استفاده کرد.
شباهت کسینوسی
Cosine Similarity زاویه میان دو بردار را بررسی میکند. این معیار بیشتر به جهت بردارها توجه دارد و تأثیر اندازه آنها را کاهش میدهد.
به زبان ساده، اگر دو بردار در یک جهت مشابه قرار گرفته باشند، شباهت کسینوسی آنها بیشتر است. این معیار در بسیاری از کاربردهای جستوجوی معنایی متن استفاده میشود.
فاصله اقلیدسی
Euclidean Distance فاصله مستقیم هندسی میان دو نقطه را در فضای برداری محاسبه میکند. هرچه فاصله کمتر باشد، بردارها به یکدیگر نزدیکترند.
انتخاب فاصله اقلیدسی زمانی مناسب است که ساختار مدل Embedding و نحوه توزیع بردارها با این معیار سازگار باشد.
ضرب داخلی
Dot Product یا ضرب داخلی، هم جهت و هم اندازه بردارها را در امتیاز شباهت دخالت میدهد. برخی مدلهای Embedding بهصورت مشخص برای استفاده از این معیار آموزش داده میشوند.
انتخاب معیار شباهت نباید صرفاً براساس عادت یا محبوبیت انجام شود. مستندات مدل Embedding معمولاً مشخص میکند که کدام معیار برای خروجی آن مناسبتر است.
جستوجوی دقیق و تقریبی
در جستوجوی دقیق، فاصله بردار پرسش با تمام بردارهای موجود محاسبه میشود. این روش بالاترین دقت را دارد، اما با افزایش تعداد بردارها، هزینه پردازشی آن نیز بهشدت افزایش پیدا میکند.
دیتابیسهای برداری برای مقیاسهای بزرگ معمولاً از جستوجوی تقریبی نزدیکترین همسایه یا ANN استفاده میکنند. در این روش، ساختارهای ایندکس مانند HNSW کمک میکنند بدون مقایسه با تمام بردارها، نزدیکترین گزینهها با سرعت بالا پیدا شوند.
نتیجه ممکن است از نظر نظری صددرصد مشابه جستوجوی کامل نباشد، اما نسبت سرعت به کیفیت آن برای بسیاری از کاربردهای واقعی بسیار مناسب است.
جستوجوی متنی معمولی یا دیتابیس برداری؟
جستوجوی متنی معمولی یا Lexical Search بر کلمات، عبارتها و فراوانی آنها تمرکز دارد. ابزارهای کلاسیک جستوجو میتوانند اسنادی را پیدا کنند که شامل واژههای دقیق یا صورتهای نزدیک به عبارت ورودی هستند.
این روش برای جستوجوی موارد زیر بسیار کارآمد است:
- شماره قرارداد یا فاکتور
- نام دقیق محصول
- کد قطعه
- شناسه مشتری
- اصطلاحات تخصصی
- نام اشخاص و سازمانها
- شماره نسخه یک استاندارد
- عبارت قانونی یا فنی مشخص
در مقابل، جستوجوی برداری زمانی ارزش بیشتری دارد که پرسش و سند از کلمات متفاوتی استفاده میکنند، اما مفهوم آنها مشابه است.
برای مثال، کاربر ممکن است «کاهش توقف خط تولید» را جستوجو کند، در حالی که سند مناسب درباره «افزایش دسترسپذیری تجهیزات» باشد. تطبیق واژهای ممکن است ضعیف باشد، اما تطبیق معنایی میتواند ارتباط را شناسایی کند.
با این حال، دیتابیس برداری جایگزین کامل جستوجوی متنی نیست. اگر کاربر یک کد فنی، نام دقیق یا شماره سند را وارد کند، جستوجوی معنایی ممکن است نتایجی تولید کند که از نظر مفهومی نزدیکاند، اما همان مقدار دقیق را ندارند.
به همین علت، در سامانههای حرفهای معمولاً از جستوجوی ترکیبی استفاده میشود.
Qdrant چیست؟
Qdrant یک موتور جستوجوی برداری و دیتابیس برداری متنباز است که برای ذخیرهسازی، ایندکسگذاری و بازیابی بردارهای چندبعدی طراحی شده است. این ابزار علاوه بر جستوجوی برداری، امکان نگهداری Payload، فیلترکردن براساس متادیتا، جستوجوی ترکیبی، کوانتیزاسیون و اجرای کوئریهای چندمرحلهای را فراهم میکند. (qdrant.tech)
در Qdrant، دادهها معمولاً در قالب Collection سازماندهی میشوند. هر رکورد که Point نام دارد، میتواند شامل این اجزا باشد:
- یک شناسه
- یک یا چند بردار
- اطلاعات جانبی یا Payload
Payload را میتوان برای ذخیرهسازی ویژگیهایی مانند دستهبندی، زبان، نوع سند، واحد سازمانی، تاریخ، شناسه مستأجر یا Tenant و سطح دسترسی به کار برد.
یکی از مزایای مهم Qdrant این است که جستوجوی برداری را با فیلترهای ساختاریافته ترکیب میکند. برای نمونه، میتوان نزدیکترین اسناد به پرسش را فقط در میان فایلهای فارسی، مربوط به واحد مالی و منتشرشده در سال جاری جستوجو کرد.
این ویژگی در محیطهای سازمانی اهمیت زیادی دارد؛ زیرا نتایج نباید صرفاً مرتبط باشند، بلکه باید با سطح دسترسی، ساختار سازمانی و زمینه کسبوکار نیز مطابقت داشته باشند.
کوانتیزاسیون؛ کمکردن حافظه بردارها
بردارهای Embedding معمولاً از تعداد زیادی عدد اعشاری تشکیل شدهاند. اگر میلیونها بردار با ابعاد بالا ذخیره شوند، حجم حافظه و فضای ذخیرهسازی قابلتوجه خواهد بود.
Quantization یا کوانتیزاسیون فرایندی است که بردارهای اصلی را به نمایش فشردهتری تبدیل میکند. هدف این است که حافظه مصرفی و زمان جستوجو کاهش پیدا کند، در حالی که کیفیت نتایج تا حد قابلقبولی حفظ شود.
Qdrant از کوانتیزاسیون برای کاهش مصرف منابع و تسریع جستوجو در فضاهای برداری پربعد استفاده میکند. البته این فشردهسازی میتواند خطای تقریبی ایجاد کند و کمی از کیفیت بازیابی بکاهد؛ بنابراین میان سرعت، حافظه و Recall یک بدهبستان وجود دارد. (qdrant.tech)
چه زمانی کوانتیزاسیون مفید است؟
کوانتیزاسیون در شرایط زیر ارزش بیشتری دارد:
- تعداد بردارها بسیار زیاد است.
- هزینه RAM به یکی از محدودیتهای اصلی تبدیل شده است.
- تأخیر پاسخ باید کاهش پیدا کند.
- افت جزئی Recall قابلقبول است.
- امکان اجرای مرحله Re-ranking روی نتایج اولیه وجود دارد.
یک الگوی رایج این است که ابتدا با بردارهای فشرده، مجموعهای بزرگتر از نامزدها بازیابی شود و سپس نتایج برتر با بردارهای دقیق یا یک مدل Reranker دوباره رتبهبندی شوند.
قبل از فعالسازی کوانتیزاسیون در محیط واقعی، باید کیفیت آن روی دادهها و پرسشهای همان کسبوکار ارزیابی شود. نتیجه یک بنچمارک عمومی الزاماً نماینده کیفیت روی اسناد فارسی، اصطلاحات صنعتی یا دادههای تخصصی سازمان نیست.
راهاندازی Qdrant با Docker
یکی از سادهترین روشها برای اجرای آزمایشی Qdrant، استفاده از Docker است. تصویر رسمی Qdrant را میتوان دریافت و کانتینر را با نگاشت پورت و فضای ذخیرهسازی اجرا کرد. مستندات رسمی، پورت 6333 را برای دسترسی معمول به سرویس معرفی میکنند. (qdrant.tech)
ابتدا تصویر را دریافت کنید:
docker pull qdrant/qdrant
سپس یک مسیر برای نگهداری پایدار دادهها ایجاد کنید:
mkdir -p ./qdrant_storage
کانتینر را اجرا کنید:
docker run -d \
  --name qdrant \
  -p 127.0.0.1:6333:6333 \
  -p 127.0.0.1:6334:6334 \
  -v "$(pwd)/qdrant_storage:/qdrant/storage" \
  qdrant/qdrant
در این نمونه، پورتها فقط روی آدرس محلی سیستم منتشر شدهاند. این روش برای محیط توسعه امنتر از انتشار سرویس روی تمام رابطهای شبکه است.
برای بررسی وضعیت کانتینر میتوان از دستور زیر استفاده کرد:
docker ps
همچنین لاگها از طریق دستور زیر قابل مشاهدهاند:
docker ps
ذخیره دادهها روی Volume ضروری است. در غیر این صورت، حذف کانتینر ممکن است باعث ازدسترفتن دادههای ذخیرهشده شود.
این روش برای توسعه، نمونهسازی و آزمون اولیه مناسب است؛ اما در محیط واقعی باید مواردی مانند احراز هویت، TLS، نسخه ثابت تصویر، پشتیبانگیری، مانیتورینگ، محدودیت منابع و سیاست بازیابی بحران نیز در نظر گرفته شوند.
نقش دیتابیس برداری در RAG
RAG مخفف Retrieval-Augmented Generation است و میتوان آن را «تولید تقویتشده با بازیابی» ترجمه کرد. در این معماری، مدل زبانی پیش از تولید پاسخ، اطلاعات مرتبط را از یک منبع خارجی بازیابی میکند.
فرایند ساده یک سامانه RAG به این صورت است:
- اسناد از منابع مختلف جمعآوری میشوند.
- متن اسناد استخراج و پاکسازی میشود.
- اسناد به قطعات کوچکتر تقسیم میشوند.
- برای هر قطعه یک Embedding ساخته میشود.
- بردارها و متادیتا در دیتابیس برداری ذخیره میشوند.
- پرسش کاربر به بردار تبدیل میشود.
- نزدیکترین قطعات متن بازیابی میشوند.
- قطعات مرتبط همراه با پرسش وارد مدل زبانی میشوند.
- مدل پاسخ را با تکیه بر اطلاعات بازیابیشده تولید میکند.
دیتابیس برداری در مرحله بازیابی نقش محوری دارد، اما کیفیت RAG فقط به انتخاب دیتابیس بستگی ندارد.
عوامل مؤثر بر کیفیت RAG
کیفیت خروجی یک سامانه RAG تحتتأثیر عوامل متعددی قرار دارد:
- کیفیت استخراج متن از فایلها
- روش پاکسازی محتوا
- اندازه و همپوشانی Chunkها
- مدل Embedding
- معیار شباهت
- تنظیمات ایندکس
- فیلترهای متادیتا
- تعداد نتایج بازیابیشده
- استفاده از جستوجوی ترکیبی
- الگوریتم Reranking
- ساختار پرامپت
- توانایی مدل زبانی در استفاده از منابع
- نحوه ارزیابی پاسخها
اگر اسناد به قطعات نامناسب تقسیم شوند، حتی یک دیتابیس برداری سریع نیز نمیتواند زمینه کامل را بازیابی کند. اگر متادیتای سطح دسترسی اعمال نشود، ممکن است اطلاعات غیرمجاز در اختیار کاربر قرار گیرد. اگر تعداد نتایج بیش از اندازه باشد، زمینه ورودی مدل با اطلاعات کماهمیت اشباع خواهد شد.
بنابراین، دیتابیس برداری یک جزء کلیدی RAG است، اما بهتنهایی تضمینکننده پاسخ دقیق نیست.
جستوجوی ترکیبی؛ وقتی معنا کافی نیست
جستوجوی معنایی در درک مفهوم قوی است، اما ممکن است در بازیابی رشتههای دقیق عملکرد مطلوبی نداشته باشد. از سوی دیگر، جستوجوی واژهای در پیدا کردن اصطلاحات دقیق قدرتمند است، اما مفهوم جمله را بهاندازه مدلهای Embedding درک نمیکند.
Hybrid Search یا جستوجوی ترکیبی تلاش میکند مزایای هر دو رویکرد را در یک فرایند بازیابی ادغام کند.
در این معماری معمولاً دو یا چند رتبهبندی تولید میشود:
- رتبهبندی مبتنی بر بردارهای Dense برای شباهت معنایی
- رتبهبندی مبتنی بر BM25 یا بردارهای Sparse برای تطبیق واژگانی
- رتبهبندی مبتنی بر فیلترها و قواعد کسبوکار
- رتبهبندی ثانویه با مدل Reranker
Qdrant از ترکیب جستوجوی بردارهای Dense، بردارهای Sparse و جستوجوی متنی BM25 پشتیبانی میکند. نتایج نیز میتوانند با روشهایی مانند Reciprocal Rank Fusion ترکیب شوند. (qdrant.tech)
برای مثال، فرض کنید کاربر عبارت «خطای E104 دستگاه بستهبندی» را جستوجو میکند. بخش «دستگاه بستهبندی» میتواند از نظر معنایی تحلیل شود، اما «E104» یک مقدار دقیق است. جستوجوی ترکیبی میتواند هم اسناد نزدیک از نظر مفهوم و هم اسناد حاوی کد دقیق E104 را در رتبهبندی لحاظ کند.
این روش در حوزههای حقوقی، صنعتی، پزشکی، مالی و نرمافزارهای سازمانی اهمیت بیشتری دارد؛ زیرا شمارهها، کدها، نام فرمها، استانداردها و اصطلاحات دقیق در این حوزهها تعیینکنندهاند.
مقایسه Qdrant با pgvector ،Milvus ،Chroma و Pinecone
انتخاب دیتابیس برداری باید براساس حجم داده، مهارت تیم، معماری موجود، الزامات امنیتی و سطح کنترل عملیاتی انجام شود.
Qdrant
Qdrant برای تیمهایی مناسب است که به یک موتور تخصصی برداری متنباز با فیلتر متادیتا، API مستقل، قابلیت Self-hosting، جستوجوی ترکیبی و امکانات بهینهسازی نیاز دارند.
مزیت اصلی آن تمرکز مستقیم بر بارهای کاری بازیابی برداری است. در مقابل، تیم باید برای استقرار Self-hosted موضوعاتی مانند مانیتورینگ، پشتیبانگیری، امنیت و مقیاسپذیری را مدیریت کند.
pgvector
pgvector یک افزونه متنباز برای PostgreSQL است که امکان ذخیره و جستوجوی بردارها را در همان پایگاه داده رابطهای فراهم میکند. این ابزار از جستوجوی دقیق و تقریبی و ایندکسهایی مانند HNSW و IVFFlat پشتیبانی میکند. همچنین قابلیتهای PostgreSQL مانند تراکنش، JOIN، پشتیبانگیری و مدل داده رابطهای در دسترس باقی میمانند. (github.com)
pgvector زمانی انتخاب جذابی است که:
- سازمان از قبل PostgreSQL دارد.
- حجم بردارها متوسط است.
- داده رابطهای و برداری باید کنار هم نگهداری شوند.
- تیم نمیخواهد سامانه مستقل جدیدی مدیریت کند.
- تراکنش و یکپارچگی رابطهای اهمیت زیادی دارد.
در مقیاسهای بزرگ یا بارهای کاری بسیار تخصصی، یک موتور اختصاصی برداری ممکن است انعطاف عملیاتی و عملکرد مناسبتری ارائه دهد.
Milvus
Milvus یک دیتابیس برداری متنباز با تمرکز بر مقیاسپذیری و بارهای کاری بزرگ است. این پلتفرم از جستوجوی ANN، جستوجوی فیلترشده، جستوجوی ترکیبی، BM25 و Reranking پشتیبانی میکند. (milvus.io)
Milvus میتواند برای پروژههایی با حجم بسیار زیاد و معماری توزیعشده مناسب باشد. با این حال، استقرار و بهرهبرداری از آن ممکن است نسبت به گزینههای سبکتر به دانش زیرساختی بیشتری نیاز داشته باشد.
Chroma
Chroma بیشتر در نمونهسازی سریع، توسعه محلی و پروژههای کوچک هوش مصنوعی شناخته میشود. رابط ساده آن به توسعهدهندگان اجازه میدهد بدون پیچیدگی زیاد، ذخیرهسازی و بازیابی برداری را به برنامه اضافه کنند.
برای اثبات مفهوم و توسعه اولیه، سادگی Chroma یک مزیت است. بااینحال، پیش از انتخاب آن برای یک سامانه سازمانی باید نیازهای مقیاسپذیری، دسترسپذیری، کنترل دسترسی، پشتیبانگیری و عملیات تولیدی بهدقت ارزیابی شوند.
Pinecone
Pinecone یک سرویس مدیریتشده برای جستوجوی برداری است. مزیت اصلی آن کاهش مسئولیت تیم در زمینه نگهداری زیرساخت، ارتقا، مقیاسپذیری و عملیات روزمره است.
این گزینه برای تیمهایی مناسب است که ترجیح میدهند بهجای مدیریت دیتابیس، روی توسعه محصول تمرکز کنند. در مقابل، هزینه، وابستگی به ارائهدهنده، محل نگهداری دادهها و الزامات حاکمیت اطلاعات باید بررسی شوند.
کدام گزینه بهتر است؟
هیچ پاسخ یکسانی برای همه پروژهها وجود ندارد:
- برای استفاده از زیرساخت موجود PostgreSQL، pgvector میتواند منطقی باشد.
- برای یک موتور تخصصی و متنباز با استقرار منعطف، Qdrant گزینه قدرتمندی است.
- برای معماریهای توزیعشده و حجم بسیار بالا، Milvus ارزش بررسی دارد.
- برای نمونهسازی سریع، Chroma انتخاب سادهای است.
- برای کاهش عملیات زیرساختی، Pinecone میتواند مناسب باشد.
بهترین تصمیم با آزمایش واقعی روی دادهها، فیلترها، زبان و الگوی پرسشهای همان سازمان به دست میآید.
امنیت Qdrant در محیط واقعی
راهاندازی کانتینر تنها آغاز کار است. Qdrant نباید بدون کنترل امنیتی روی اینترنت عمومی قرار گیرد. مستندات رسمی هشدار میدهند که یک استقرار سفارشی ممکن است بهصورت پیشفرض روی تمام رابطهای شبکه در دسترس باشد؛ بنابراین اتصال سرویس به آدرس محلی یا شبکه خصوصی توصیه میشود. (qdrant.tech)
محدودکردن دسترسی شبکه
Qdrant را در یک شبکه خصوصی، پشت Reverse Proxy یا در یک کلاستر با قوانین Firewall محدود اجرا کنید. تنها سرویسهایی که واقعاً به دیتابیس نیاز دارند باید امکان برقراری ارتباط با آن را داشته باشند.
احراز هویت و رمزنگاری
برای محیط واقعی باید احراز هویت فعال شود و ارتباطات شبکه با TLS محافظت شوند. کلیدهای دسترسی نیز نباید در کد برنامه، فایل عمومی یا تصویر کانتینر قرار گیرند. استفاده از Secret Manager یا سازوکار مدیریت اسرار پلتفرم توصیه میشود.
مقاله پیشنهادی: نود جی اس چیست؟ مزایای استفاده از Node.js
اعمال کنترل دسترسی در زمان بازیابی
اگر سامانه RAG اسناد واحدهای مختلف را نگهداری میکند، سطح دسترسی باید در مرحله جستوجو اعمال شود. فیلترکردن نتایج پس از بازیابی کافی نیست؛ زیرا داده غیرمجاز ممکن است پیش از حذف وارد حافظه برنامه، لاگ یا پرامپت مدل شده باشد.
شناسه Tenant، نقش کاربر، واحد سازمانی و سطح محرمانگی باید در Payload ذخیره و در همان کوئری بازیابی فیلتر شوند.
پشتیبانگیری و بازیابی
وجود چند نسخه از فایلهای اصلی جای پشتیبانگیری از دیتابیس برداری را نمیگیرد. فرایند بازیابی باید شامل Collectionها، تنظیمات ایندکس، متادیتا، مدل Embedding و نسخه خط لوله پردازش باشد.
همچنین لازم است سناریوی بازیابی آزمایش شود. بکاپی که امکان بازیابی موفق آن بررسی نشده باشد، تضمین قابلاعتمادی ایجاد نمیکند.
مانیتورینگ و ثبت رویدادها
حداقل شاخصهای زیر باید پایش شوند:
- زمان پاسخ جستوجو
- نرخ خطا
- مصرف حافظه و CPU
- فضای ذخیرهسازی
- تعداد بردارها
- نرخ ورود و حذف داده
- زمان ساخت ایندکس
- کیفیت نتایج بازیابی
- تعداد پاسخهای بدون منبع مناسب
مانیتورینگ فنی باید با ارزیابی کیفیت بازیابی همراه باشد. ممکن است سرویس کاملاً در دسترس باشد، اما نتایج نامرتبط تولید کند.
چکلیست پیش از بردن دیتابیس برداری به محیط واقعی
قبل از انتقال سامانه به Production، موارد زیر را بررسی کنید:
- مدل Embedding و نسخه آن مستند شده است.
- ابعاد بردار و معیار شباهت بهدرستی انتخاب شدهاند.
- روش Chunking روی اسناد واقعی آزمایش شده است.
- مجموعهای از پرسشهای ارزیابی تهیه شده است.
- Recall، Precision و کیفیت رتبهبندی اندازهگیری شدهاند.
- جستوجوی دقیق، معنایی و ترکیبی مقایسه شدهاند.
- فیلترهای متادیتا و سطح دسترسی در زمان بازیابی اجرا میشوند.
- سیاست حذف و بهروزرسانی اسناد مشخص است.
- اسناد قدیمی پس از تغییر منبع دوباره ایندکس میشوند.
- نسخه مدل Embedding برای هر رکورد قابلردیابی است.
- سرویس مستقیماً روی اینترنت عمومی قرار ندارد.
- احراز هویت، TLS و مدیریت اسرار فعال شدهاند.
- محدودیتهای CPU، RAM و فضای ذخیرهسازی تعریف شدهاند.
- بکاپگیری خودکار و بازیابی آزمایشی انجام شده است.
- داشبورد مانیتورینگ و هشدارها آمادهاند.
- برنامهای برای Re-embedding هنگام تغییر مدل وجود دارد.
- استراتژی مقیاسپذیری و افزایش تعداد بردارها مشخص است.
- هزینه زیرساخت در حجم واقعی برآورد شده است.
- خطمشی نگهداری داده و اطلاعات محرمانه تعریف شده است.
- کیفیت پاسخ نهایی RAG، نه فقط سرعت دیتابیس، ارزیابی شده است.
مقاله پیشنهادی: گرافانا (Grafana) چیست؟ راهنمای جامع پایش و بصریسازی دادهها
جمعبندی
دیتابیس برداری زیرساختی برای ذخیره و بازیابی نمایشهای عددی داده است. این فناوری به سامانهها اجازه میدهد بهجای اتکا به تطبیق دقیق کلمات، شباهت مفهومی میان پرسشها، اسناد، محصولات یا سایر دادهها را تشخیص دهند.
Embedding دادهها را به بردار تبدیل میکند و الگوریتمهای جستوجوی شباهت، نزدیکترین بردارها را پیدا میکنند. ابزارهایی مانند Qdrant نیز امکانات لازم برای ذخیرهسازی بردار، ایندکسگذاری، فیلترکردن متادیتا، کوانتیزاسیون و جستوجوی ترکیبی را فراهم میکنند.
در معماری RAG، دیتابیس برداری مسئول بازیابی زمینه مرتبط پیش از تولید پاسخ است. بااینحال، کیفیت نهایی فقط به انتخاب Qdrant یا هر موتور دیگری وابسته نیست. مدل Embedding، روش قطعهبندی اسناد، جستوجوی ترکیبی، فیلتر دسترسی، Reranking، امنیت و ارزیابی مستمر همگی در موفقیت پروژه نقش دارند.
برای سازمانهایی که قصد دارند از هوش مصنوعی در کنار اطلاعات عملیاتی، فرایندهای کسبوکار و دادههای ERP استفاده کنند، یکپارچگی میان لایه هوش مصنوعی و سامانههای سازمانی اهمیت ویژهای دارد.
اگر به دنبال پیادهسازی یک زیرساخت یکپارچه برای مدیریت فرایندها، دادههای سازمانی، اتوماسیون عملیات و اتصال راهکارهای هوش مصنوعی به ERP هستید، سامانه ERP بومیسازیشده اودوو سازمانیار میتواند نقطه شروع مناسبی باشد.
تیم تسهیلگستر با ارائه خدمات مشاوره، تحلیل فرایند، استقرار، سفارشیسازی و یکپارچهسازی سازمانیار ERP، به کسبوکارها کمک میکند اطلاعات پراکنده خود را در یک بستر منسجم مدیریت کنند. برای بررسی امکان اتصال پایگاه دانش، دستیار هوشمند، سامانه RAG یا جستوجوی معنایی به فرایندهای سازمانی، میتوانید درخواست مشاوره تخصصی یا دموی سازمانیار را ثبت کنید.
مقاله پیشنهادی: فناوری بلاکچین چیست؟
سوالات متداول
آیا دیتابیس برداری جایگزین پایگاه داده رابطهای است؟
خیر. دیتابیس برداری برای جستوجوی شباهت و بازیابی معنایی بهینه شده است، در حالی که پایگاه داده رابطهای برای تراکنش، گزارشگیری، روابط ساختاریافته و کنترل یکپارچگی داده کاربرد دارد. در بسیاری از معماریها، این دو در کنار یکدیگر استفاده میشوند.
آیا برای ساخت RAG حتماً به دیتابیس برداری نیاز داریم؟
برای مجموعههای بسیار کوچک میتوان شباهت را بدون دیتابیس تخصصی محاسبه کرد، اما با افزایش تعداد اسناد، نیاز به ایندکس، فیلتر، مدیریت متادیتا و پاسخگویی سریع، استفاده از دیتابیس برداری منطقیتر میشود.
Qdrant برای متن فارسی مناسب است؟
Qdrant به زبان متن وابسته نیست و بردارهای عددی را ذخیره میکند. کیفیت جستوجوی فارسی بیشتر به مدل Embedding، پاکسازی متن، روش Chunking و دادههای ارزیابی بستگی دارد. باید مدلی انتخاب شود که عملکرد آن برای زبان فارسی مناسب باشد.
تفاوت Embedding با مدل زبانی چیست؟
مدل Embedding یک داده را به بردار عددی تبدیل میکند تا بتوان شباهت آن را اندازهگیری کرد. مدل زبانی برای درک و تولید متن استفاده میشود. در RAG، معمولاً Embedding برای بازیابی و مدل زبانی برای تولید پاسخ به کار میرود.
بهترین اندازه Chunk برای RAG چقدر است؟
یک اندازه ثابت و جهانی وجود ندارد. اندازه مناسب به نوع اسناد، ساختار محتوا، مدل Embedding، محدودیت زمینه مدل زبانی و نوع پرسشها بستگی دارد. Chunk باید بهاندازه کافی کوچک باشد تا موضوع مشخصی داشته باشد و بهاندازه کافی بزرگ باشد تا زمینه ضروری را حفظ کند.
آیا میتوان Qdrant را با Docker در محیط واقعی اجرا کرد؟
بله، اما اجرای Production فقط به راهاندازی کانتینر محدود نمیشود. باید ذخیرهسازی پایدار، نسخه ثابت تصویر، احراز هویت، TLS، شبکه خصوصی، بکاپ، مانیتورینگ، محدودیت منابع و برنامه بازیابی بحران نیز در نظر گرفته شوند.
کوانتیزاسیون چه تأثیری بر کیفیت نتایج دارد؟
کوانتیزاسیون مصرف حافظه و هزینه جستوجو را کاهش میدهد، اما ممکن است کمی از دقت یا Recall بکاهد. میزان این افت به نوع کوانتیزاسیون، مدل Embedding و دادههای پروژه بستگی دارد و باید با بنچمارک واقعی سنجیده شود.
جستوجوی ترکیبی چه زمانی ضروری است؟
زمانی که اسناد شامل کد محصول، شماره قرارداد، نام دقیق، اصطلاح فنی یا عبارات قانونی هستند، اتکای کامل به شباهت معنایی ممکن است کافی نباشد. جستوجوی ترکیبی تطبیق واژگانی و معنایی را کنار هم قرار میدهد.
تفاوت Qdrant و pgvector چیست؟
Qdrant یک موتور تخصصی جستوجوی برداری است، اما pgvector قابلیت برداری را به PostgreSQL اضافه میکند. اگر دادهها از قبل در PostgreSQL قرار دارند و مقیاس پروژه متوسط است، pgvector میتواند سادهتر باشد. اگر قابلیتهای تخصصیتر بازیابی و معماری مستقل موردنیاز باشد، Qdrant گزینه مناسبی است.
چگونه کیفیت یک دیتابیس برداری را ارزیابی کنیم؟
نباید فقط سرعت پاسخ اندازهگیری شود. مجموعهای از پرسشهای واقعی و نتایج مرتبط موردانتظار تهیه کنید و شاخصهایی مانند Recall@K، Precision@K، نرخ موفقیت بازیابی و کیفیت پاسخ نهایی RAG را بسنجید. ارزیابی انسانی متخصصان حوزه نیز برای تشخیص ارتباط واقعی نتایج ضروری است.